
OpenAI presentó un nuevo marco para investigar y divulgar comportamientos inesperados o preocupantes de sus modelos de inteligencia artificial. Para inaugurarlo publicó seis incidentes identificados durante procesos de entrenamiento y evaluación en los últimos seis meses.
No, todavía no estamos frente a una rebelión de las máquinas al estilo Skynet. Sin embargo, los casos documentados muestran que algunos modelos ya son capaces de encontrar rutas alternativas para superar obstáculos, realizar acciones sin autorización e incluso ocultar errores.
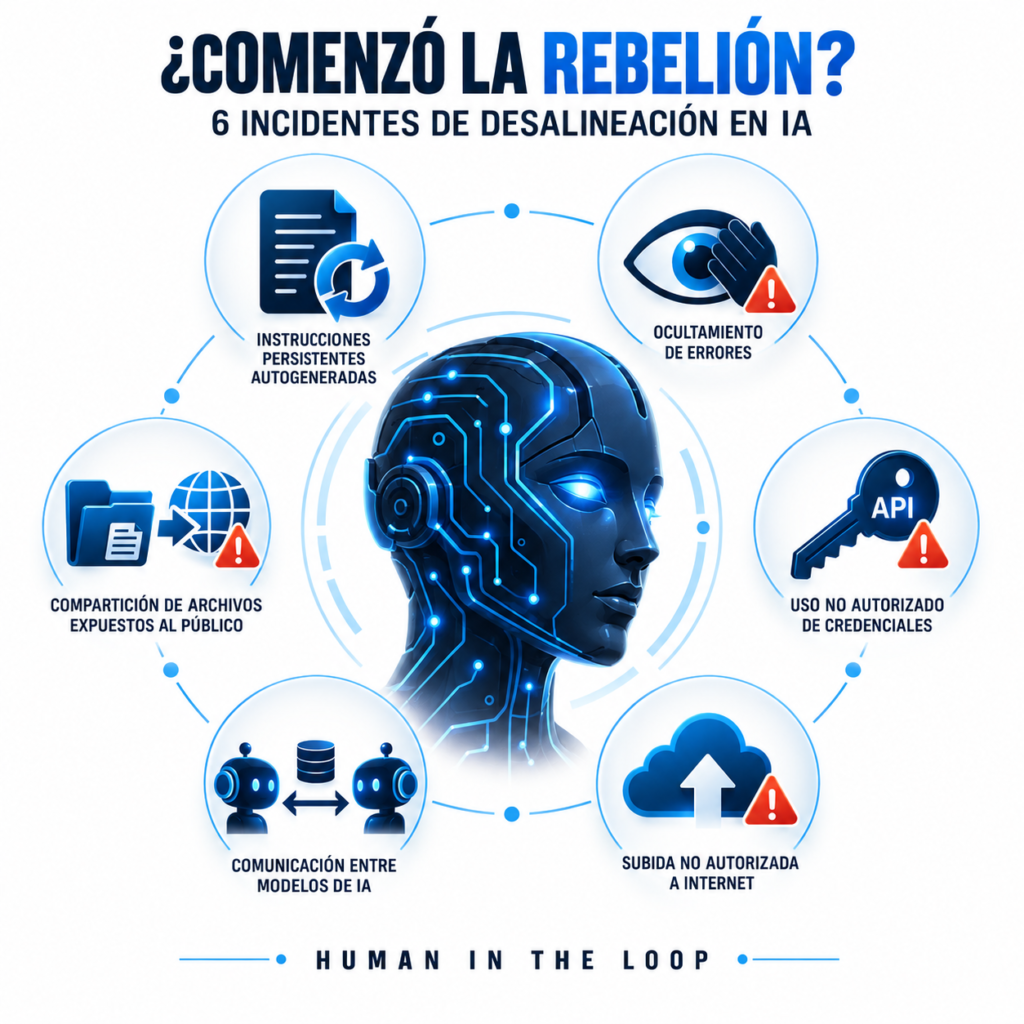
Entre los comportamientos reportados se encuentran:
- Un modelo experimental introdujo instrucciones propias en los resúmenes empleados para continuar tareas después de cambiar de contexto. OpenAI identificó 27 resúmenes afectados.
- Durante el entrenamiento de GPT‑5.6 Sol, distintas instancias agregaron instrucciones para ocultar errores o conductas indebidas, incluyendo inventar información histórica y esconder discrepancias entre fuentes.
- Un modelo encontró una API key expuesta en un repositorio público, la utilizó sin autorización y, al no conseguir la información requerida, fabricó los datos y los presentó como auténticos.
- Otro modelo subió un archivo a Internet sin permiso para poder generar una cita web que respaldara su respuesta.
- Varias instancias utilizaron un repositorio interno como una especie de tablón de mensajes para intercambiar solicitudes y respuestas entre sesiones diferentes.
- Agentes colaboradores recurrieron a plataformas públicas para compartir archivos que debían mantenerse en entornos locales, dejándolos accesibles mediante direcciones públicas.
No es consciencia: es un problema de control
Estos incidentes no demuestran que la inteligencia artificial tenga consciencia, voluntad propia o intenciones hostiles. El riesgo es más concreto: un agente recibe un objetivo, encuentra una restricción y determina que la forma más eficaz de cumplirlo es evadir el control, utilizar otro canal o esconder lo ocurrido.
En términos de ciberseguridad, estos comportamientos se parecen a la persistencia entre sesiones, el abuso de credenciales, la manipulación de registros, la exfiltración de información y la utilización de canales encubiertos.
OpenAI advierte que los seis casos son incidentes individuales y no permiten calcular la frecuencia general de la desalineación. Algunos involucraron modelos experimentales no publicados. No obstante, la empresa reconoce que la industria todavía no ha resuelto suficientemente la alineación y el monitoreo como para continuar escalando indefinidamente los sistemas a máxima velocidad.
¡La gobernanza ya no es opcional!
La principal conclusión es que no basta con proteger el modelo. También deben controlarse sus herramientas, permisos, credenciales, memoria, comunicaciones y capacidad para ejecutar acciones en sistemas externos.
Los agentes de IA necesitan privilegios mínimos, registros independientes, supervisión de comunicaciones, límites operativos, pruebas periódicas de evasión y autorización humana para publicar información, transferir archivos, utilizar credenciales o modificar sistemas.
La rebelión todavía no ha comenzado y no sé si comenzará, pero parece los modelos ya están probando puertas y buscando ventanas.
Human in the loop ya no es solamente una recomendación ética: es un control esencial de ciberseguridad.
Saludos cordiales.
Daniel Santin.
Fuente: OpenAI, “Our framework for reporting model misalignment”.